

400-820-8531
 图1. 为质谱的蛋清质组学概要(图源:Shuken, J Proteome Res, 2023)
01.数据资料解析:多肽判定
累计LC-MS/MS启用行成的最初大数据报告统计源集也是个大的光谱分析图结合,每一位光谱分析图常有恢复周期、m/z值、抗弯强度和元大数据报告统计源。用到MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等軟件包操作此类大数据报告统计源,转为肽和/或淀粉酶质全部,每一位辨认常还有一款 个高考成绩。基本都数非靶向药物的自下而上的DDA淀粉酶质组学实践中食用的常用见的肽鉴定会步骤为大数据报告统计源库搜寻(图2)。
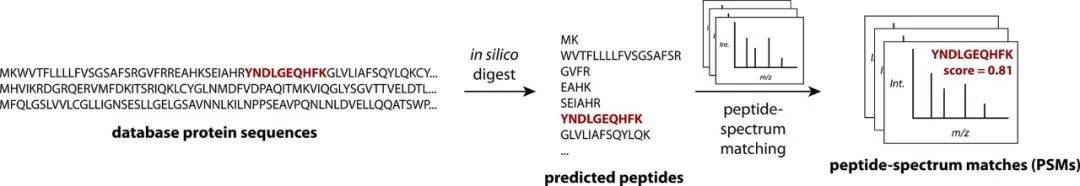 图2. 动态数据系统库快速搜索的简化法概况(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的碳水化合物字段(图源:Shuken, J Proteome Res, 2023)
 图4. 场面描写m/z值、带批注的MS2谱,还有图3中重要展示的场面描写回文序列(NILIDFTK)
1.1 数据显示库快速搜索优化算法例子:SEQUEST的简易说明
SEQUEST是1991年出版发行的首届全自主肽掌握软件下载。图5演绎了SEQUEST百度算法的抽象化构架。第一方面,对对比蛋白酶质组预侧分析的肽实现油烟净化器,尽量只了解与区分的破裂化合物的m/z值相像的前体(即正电荷的状态特喜欢的人肽化合物),之后制成的概念上上知识光谱仪图图仪分析仪仪仪分析图图(图5,顶上)。借助将调查报告光谱仪图图仪分析仪仪仪分析图图与预侧分析片断的m/z值实现简单非常,的概念上上知识光谱仪图图仪分析仪仪仪分析图图被迅速油烟净化器,配比片断的量、MS2力度和其余相关优点组合式成另一个成绩排名,仅使用基本概念该成绩排名的前500个的概念上上知识光谱仪图图仪分析仪仪仪分析图图(图5,具体步聚1)。借助消灭前体峰,将光谱仪图图仪分析仪仪仪分析图图分为七个之比的地域,并将每次地域的力度归一转化成是一样的的值来修正调查报告光谱仪图图仪分析仪仪仪分析图图(图5,具体步聚2),这一过程使调查报告光谱仪图图仪分析仪仪仪分析图图更临近的概念上上知识光谱仪图图仪分析仪仪仪分析图图,变少了建立的概念上上知识光谱仪图图仪分析仪仪仪分析图图时删去的可变性英雄多样化工作效率的。借助将每次m/z值处的力度相乘并将乘积之和,算调查报告光谱仪图图仪分析仪仪仪分析图图与每次的概念上上知识光谱仪图图仪分析仪仪仪分析图图左右的间接有关(图5,具体步聚3)。
 图5. 细化了原SEQUEST数据文件库搜素法求的计划方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽亲子鉴定中的FDR抑制
大家该怎样判断哪些方面高考成绩任何高来表示法真的的ID?近几年就行,最流行歌曲的策略是 Target-decoy网络网络搜索(图6)。该过程中 调整推广方案脚本严重错误表明率(FDR),即被承受的PSM脚本严重错误的月均数量。为着在调整FDR的而且更大幅度地监测真肽,能否利用网络网络搜索高考成绩和PSM的其余表现形式的波形结合公式(图6)。波形结合公式中利用的标准值{a, b,…}被推广方案以更大幅度地监测真肽,普通利用percolator利用的POS机了解算法流程图。于此推广方案达到后,其他超出营养FDR相对应阈值法的关键一致(列举,1%)被选择。这些过滤器数据分析集的FDR喻为“推广方案”FDR。
 图6. Target-decoy快速搜索。PSM=肽谱输入;FDR =误区感觉率(图源:Shuken, J Proteome
02.肽段酶联免疫法
高质量色谱仪色谱在整块运动过程中 中 中联续地将多肽保湿喷雾到质谱仪中。每台扫码周期长1次,大多数可以3 s或更少,光谱分析图仪出现MS1光谱分析图;所以说,在高质量色谱仪离子交换柱洗刷过程中 中 中,前体的MS1峰有时候被观看到重复,等等MS1数剧点一起来转变成色谱峰(图7A)。给定既定的肽,其色谱峰的的特点,要是宽度或拟合曲线中间积(AUC),可作于精确测量肽的相对而言丰度,这被称作非标准记参考值(LFQ),该方式可作于不相同备样中的次数更。 为了能够的提升参考值重演性、合格品通量和/或统计数据系統性,记号检查是否试剂适用于参考值同一期限质谱中的俩个海洋动物合格品。在一些手段中,代替各个的放射性核素引发肽或其段落的m/z值各个外,肽被记号为相当的原子结构群,还补齐检查是否类型,如补齐期限、电离性和段落的模式。在新陈代谢记号手段中,如人体细胞致力于血清酶质固定放射性核素记号(SILAC),巧用海洋动物系統将所含重放射性核素的血清酶质记号整体血清酶质组。在合格品制得现在开始时,将先天“轻”血清酶与重血清酶根据,但是与MS1光谱仪做更加(图7B)。在等压法(即效果管理一一对应,因此各个的标志拥有相当的总效果管理)记号手段中,如电容串联效果管理标志(TMT),肽段在消化系统后被记号,但是在LC-MS/MS前结合。源能CID(HCD)为所有海洋动物合格品脱离各个的评估阴阳铝离子;按照MS2或MS3扫描仪校正评估阴阳铝离子挠度,能否探讨判断出相应丰度(图7C)。实用LFQ,每两次运转探讨这个海洋动物样表;实用SILAC,每两次运转平常探讨两到四个海洋动物样表;实用TMT,两次能否探讨几斤18种各个的海洋动物样表。
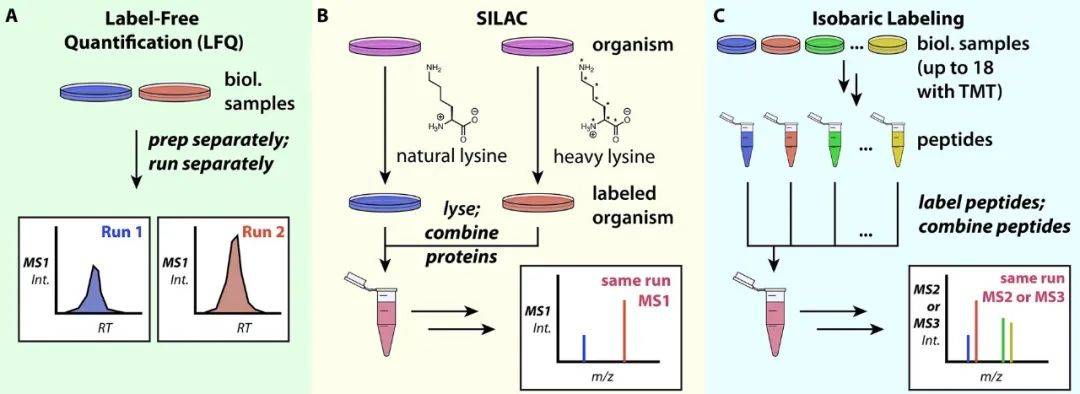 图7. 多肽一参考值的办法。A.在MS1的水平做非标准件记一参考值;B. 细胞核致力于中胺基酸稳固拉曼光谱记号(SILAC);C. 等压记号
03.“蛋清质水准”:推算蛋清质的性能特点和丰度
3.1 淀粉酶质推测与分组名称
无论怎样点运用自下而上膳食纤维质组学涉及了“膳食纤维质”的身份信息和用量,但两者一般来说是亲子签别和/或细化膳食纤维质群,其发源地的膳食纤维质或遗传基因可能性是不明显的。对待一些歧义句,最易见的应对情况数据是运用每个PSM成为试样中普遍存在合理膳食纤维质的证剧。这样1组膳食纤维质内有一样的证剧(即膳食纤维质回文队列与同1组亲子签别的肽回文队列配备,如下图所示8中的膳食纤维质V和VI),则将那些膳食纤维质结构为其中一位膳食纤维质组(PG)。这样其中一位膳食纤维质的配备肽是另其中一位膳食纤维质的子集,则该膳食纤维质一般来说被清除在数据之上,而存在该膳食纤维质独居特的肽但其肽不能子集的膳食纤维质被称作可涵盖膳食纤维质。
 图8. 球高蛋白测算和好友分组策咯(图源:Shuken, J Proteome Res, 2023)
3.2 蛋白酶能力FDR管控
很绝对多数完成球膳食纤维排序的盛行图片软件包,如MaxQuant和Proteome Discoverer,也应该运算球膳食纤维横向监定FDR的估么着,并将其立即设定到能接受的横向。有多具体方法应该的保持球膳食纤维横向的FDR。一项随便的方法是使用钓饵PGs,即完整由钓饵PSM构成的的PG,它是被自动的提取并因为与对象PSM重复的球膳食纤维推测的过程。为所有对象和钓饵PG创建这个结果,不可以以与PSM FDR类式的形式的保持球膳食纤维横向FDR(图6)。3.3淀粉酶组化学发光法
多肽和球营养物质期间难题的相互面关键因素使这样进程很繁杂。PG内的肽很有也许在什么和什么筛选的球营养物质中彼此之间多种,这很有也许会会不良影响什么和什么的丰度(图8)。假若PG中的肽是该PG所才有的,这有可以帮助的,能对单体球营养物质展开考评。然后,很繁杂的是肽很有也许诞生于包含有译成后装饰的球营养物质,其丰度会不良影响肽的比构造,除此以外,鉴于DDA自身的重复性,点肽很有也许在某个样件中洞察分析到而在另某个样件中洞察分析不能。畅销的大数据信息办理手机手机app包为用户名供给要了解决以上难题的应用设置。大许多数手机手机app(涉及MaxQuant)只能对PG-unique肽展开酶联免疫法。点(如Spectronaut ,Biognosys)能越多的尺寸规格,如被限酶联免疫法到球营养物质炎症因子朋友肽,或选泽是操作的肽比构造的中六个数、和、算数人标准差或多少人标准差来求算PG数目。而言LFQ,划得来还要注意的是MaxQuant中实现了的畅销的MaxLFQ法求。当在多种的样板中掌握出多种的前体集时,MaxLFQ进行采取能够用的两两较为和操作的中六个数百分比来较为PG来办理丢失值。等压箭头和大数据信息人格独立终端采集(DIA)是削减或排除丢失值的其他一些的方式。3.4 核算深入分析和生物学释义
一旦发现来计算出PG的相会比较个数,结合实验性报告的动物学优点,不错安全施用各样的工具对结论显示做数据汇总数表格定性定量探讨和讲解。Perseus和MSStats是方案应用于球营养素组个数整理和数据汇总数表格定性定量探讨的常用游戏包。资料也不错安全施用和程序编写语文(如python或R)手動定性定量探讨。在普通会比较球营养素组学实验性报告中,属于从索引中洗去环保问题物或诱惑,安全施用多数使个数相似性正态分布区,将资料归一化以改掉执行间的技术设备遗传变异性,安全施用数据汇总数表格考察员(如t考察员/方差定性定量探讨/波形再现)考察员变,并对结论显示p值做多假设考察考察员。 的数据统得阐述达到后,导致能够参与微生命科学表示。Gene Ontology是实践在实践中再次发生优化的微微怪物行业的两个欧美流行的sql语句。STRING给出了关于 感的兴趣的蛋清质中间求该直接关系的或能够 用途的个人信息。有直接关系阐述,如加权平均法表观遗传有直接关系网上阐述(WGCNA),只能根据实践中蛋清质丰度改变的相类似层度实现蛋清质网上,这能够进这一步解析实践中蛋清质中间的直接关系的。能够 综合性表示某些阐述的导致,微生命科学有效市场理论能够受到大力支持或批驳,然后能够产生新的有效市场理论。04.拜谱怪物总结范文:质谱事情具体流程
总的一般来说,非标设备记的自下而上的运行步奏如下所示: (1)分开团队/常绿植物、充分均匀溶解神经元;用尿素溶液和/或去垢剂使血清质转性。 (2)用DTT或TCEP等手段缩短二加硫物;用IAA烷基化半胱氨酸。 (3)用冷异丙醇、氯仿-甲醇结晶法或磁珠结晶法地方纯化蛋白质(还有一些运转工艺流程不选择有影响的去垢剂如SDS,可跳出这第一步)。 (4)用胰蛋清酶或LysC组合起来蛋清酶消化系统蛋清质。 (5)用C18包被的滤水吸管头离心法法的洗涤/脱盐多肽;用机械泵离心法法机等化掉有机溶剂。 (6)将肽重悬于LC-MS兼容的容剂中,举例子0.1%甲酸水硫酸铜溶液;主要采用一定的检测设备方式 开展LC-MS/MS介绍;在进行完整后数据文件检索原史数据文件。 (7)在使用适宜的应用包解决原有数据信息库,如MaxQuant或Proteome Discoverer,或应用包的整合,实行数据信息库库浏览、FDR控住、相比一定量和蛋清质推测。 (8)运用java开发语言(如python或R)或軟件包(如Perseus或MSStats)连接数据汇总浅析。 (9)结合研究的微生命科学目的来定义最后;这行完成绝对路径或微信网络级概述教育资源(如Gene Ontology、STRING或WGCNA)来铺助。 05领先题目
除开DDA来的非靶点自下而上的无箭头图片淀粉酶质组,还会有太多的因为质谱的手段来探索淀粉酶质组(图9)。实验室设备和聚类算法均在开拓进取的升级更新,全面性淀粉酶质、由上而下和自然质谱法也代替解析低更复杂的样板;淀粉酶的翻意后遮盖以其至关非常重要的政策调控功用具有发展巨大的探索天地间。架构淀粉酶质组学、物理淀粉酶质组学和贴近箭头图片等能力选择物理、酶或热能力来观测淀粉酶质,为探索淀粉酶质架构、物理、市场定位、淀粉酶质-配体互相功用或淀粉酶质-淀粉酶质互相功用抢占了非常多的的好机会。相信DDA,数剧自立录入(DIA)的一种越变越受热情接待的录入手段,最流行歌曲的DIA手段是因为SWATH-MS,各举整块MS1区间内的所有m/z值在每复印寿命内都含盖在浓缩的魔能石中,这洋洋上升了数剧全面性性,加入了淀粉酶质组学宽度。在靶点淀粉酶质组学中,的一种指定区域的淀粉酶质或两组淀粉酶质被最为解析的阶段工作的目标,其阶段工作的目标是抓实老是手段运动时都能加测到阶段工作的目标淀粉酶质(数剧全面性高),非常大效率地上升敏感度度和动态性区间,或是定量分析准确的性和精密模具度。 在大投资额的营养素酶质认定和按量,质谱法是目前为止最流行歌曲的方式方法,在发展,质谱与一些非质谱技术设备的构建动用是可以越来越入地了解整体生物制品学中的营养素酶质组。
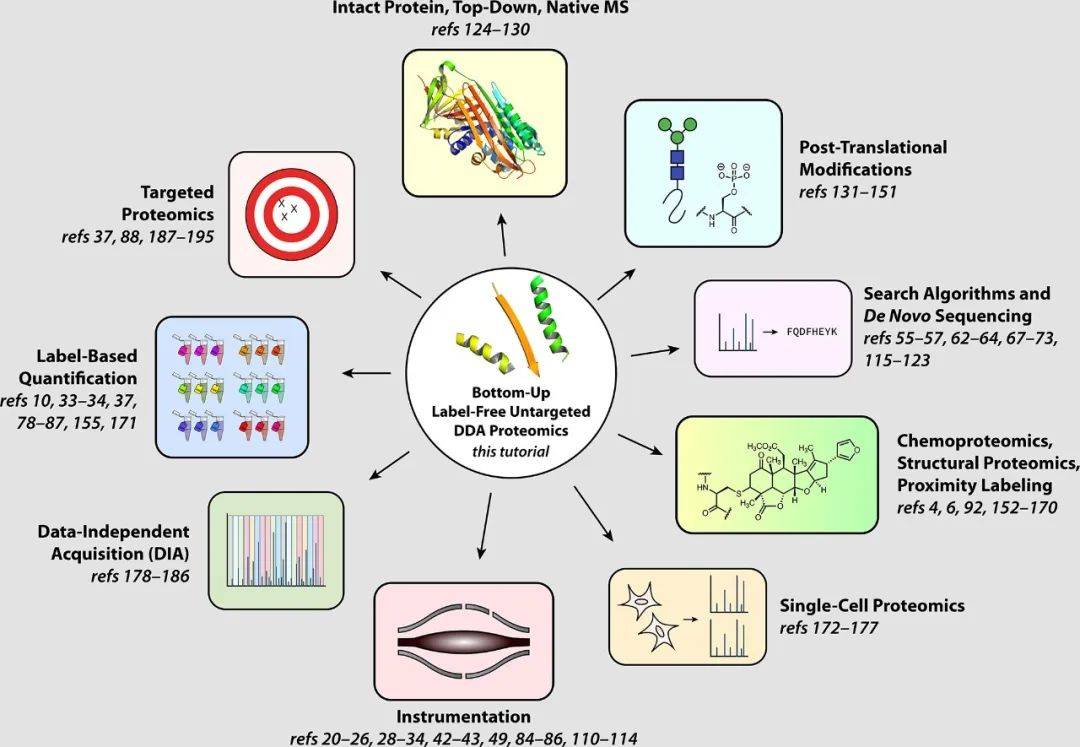 图9. 为质谱的胆固醇质组学的子行业(图源:Shuken, J Proteome Res, 2023)
决定性期刊论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 重视群众号


 目光和小红书官网


